1. 기획
문서 목적: N.DMP 직업 세그먼트 신규 구축을 위한 기획서
핵심 내용: 배경, 타사 비교, 세그먼트 정의, 데이터 구성, 활용 시나리오, 기대효과
활용 범위: 향후 설계·개발·타겟팅 전략 수립의 기준 자료
2. 활용 데이터
필요 데이터원천 데이터 정보데이터 링크
| 전국 고등학교 위치 정보 | 생활안전정보 전국 학교(초,중,고,기타) API | 오픈API Data < 오픈API : 생활안전정보 |
| 전국 대학교 위치 정보 | 생활안전정보 전국 학교(대학교) API | 오픈API Data < 오픈API : 생활안전정보 |
| 전국 기업 위치 정보 | 전자공시 opendart 시스템 기업개황 API |
전자공시 OPENDART 시스템 | 개발가이드 | 상세 |
| 기업 업종 코드 정보 | 한국무역보험공사_업종코드 api | 한국무역보험공사_업종코드_20191231 |
| 대한민국 법정동 코드 정보 | 행정안전부 법정동코드 api | 행정안전부_행정표준코드_법정동코드 |
| 위경도 좌표 정보 | 카카오맵 API | Kakao Developers |
| 사용자 위치 정보 | 나스미디어 내부 DMP 데이터 | 나스미디어 내부 DMP 데이터 |
3. 직업 세그먼트 분류 로직
- 분류 대상 : DMP 내에 월 배치를 통해 가져오는 ADID중 위 경도 좌표 정보가 존재하는 ADID이며 한국에 위치해 있으며 위치가 확인된 일자가 공휴일을 제외한 평일인 ADID
CREATE TABLE IF NOT EXISTS jaeyoung.job_segment_base (
  adid STRING,
  base_ymd STRING,
  base_hh STRING
  lat DOUBLE,
  lon DOUBLE,
  stay_cnt INT
)
PARTITIONED BY (base_ym STRING)
STORED AS PARQUET;

INSERT INTO TABLE jaeyoung.job_segment_base
PARTITION (base_ym = '${a1_strt_trgt_base_ym}')
SELECT
    adid,
    base_hh,
    base_ymd,
    CAST(admx_lat AS DOUBLE) AS lat,
    CAST(admx_lon AS DOUBLE) AS lon,
    COUNT(*) AS stay_cnt - 시간 단위 횟수
FROM
    nas_tmp.tpm_adms_adge_dd
WHERE
    base_ym = '${a1_strt_trgt_base_ym}'
    AND ADID <> '00000000-0000-0000-0000-000000000000' AND ADID IS NOT NULL
    AND UPPER(dev_geo_country) = 'KOR'
    AND admx_lat IS NOT NULL AND admx_lat <> 0.0
    AND admx_lon IS NOT NULL AND admx_lon <> 0.0
    -- 평일 및 공휴일 필터링
    AND CAST(from_unixtime(unix_timestamp(base_ymd, 'yyyyMMdd'), 'u') AS INT) BETWEEN 1 AND 5
    AND SUBSTR(base_ymd, 5, 4) NOT IN (
    '0101', -- 신정 (1월 1일)
    '0301', -- 삼일절 (3월 1일)
    '0505', -- 어린이날 (5월 5일)
    '0606', -- 현충일 (6월 6일)
    '0815', -- 광복절 (8월 15일)
    '1003', -- 개천절 (10월 3일)
    '1009', -- 한글날 (10월 9일)
    '1225'  -- 성탄절 (12월 25일)
)
GROUP BY
      ADID,
      BASE_YM,
      BASE_HH,
      ADMX_LAY,
      ADMX_LON
    ;
job_segment_base 테이블은 직업 세그먼트의 베이스가 되는 adid 테이블
- 현 시점 ****tpm_adms_adge_dd 테이블에 202509 ~ 202511 데이터 만 존재하기에 기간을 09~11로 설정
(202509 ~ 202511 기준) 전체 adid 수 - 약 32억 만 건
(202509 ~ 202511 기준) unique adid 수 - 약 6억
1. 분류 로직
목적: ADID 신분과 직업으로 분류
ADID 신분 직업
| abc123 | 학생 | 대학생 |
| abc456 | 학생 | 고등학생 |
| def345 | 근로자 | 통신업 |
| def678 | 근로자 | 제조업 |
분류 로직:
학생
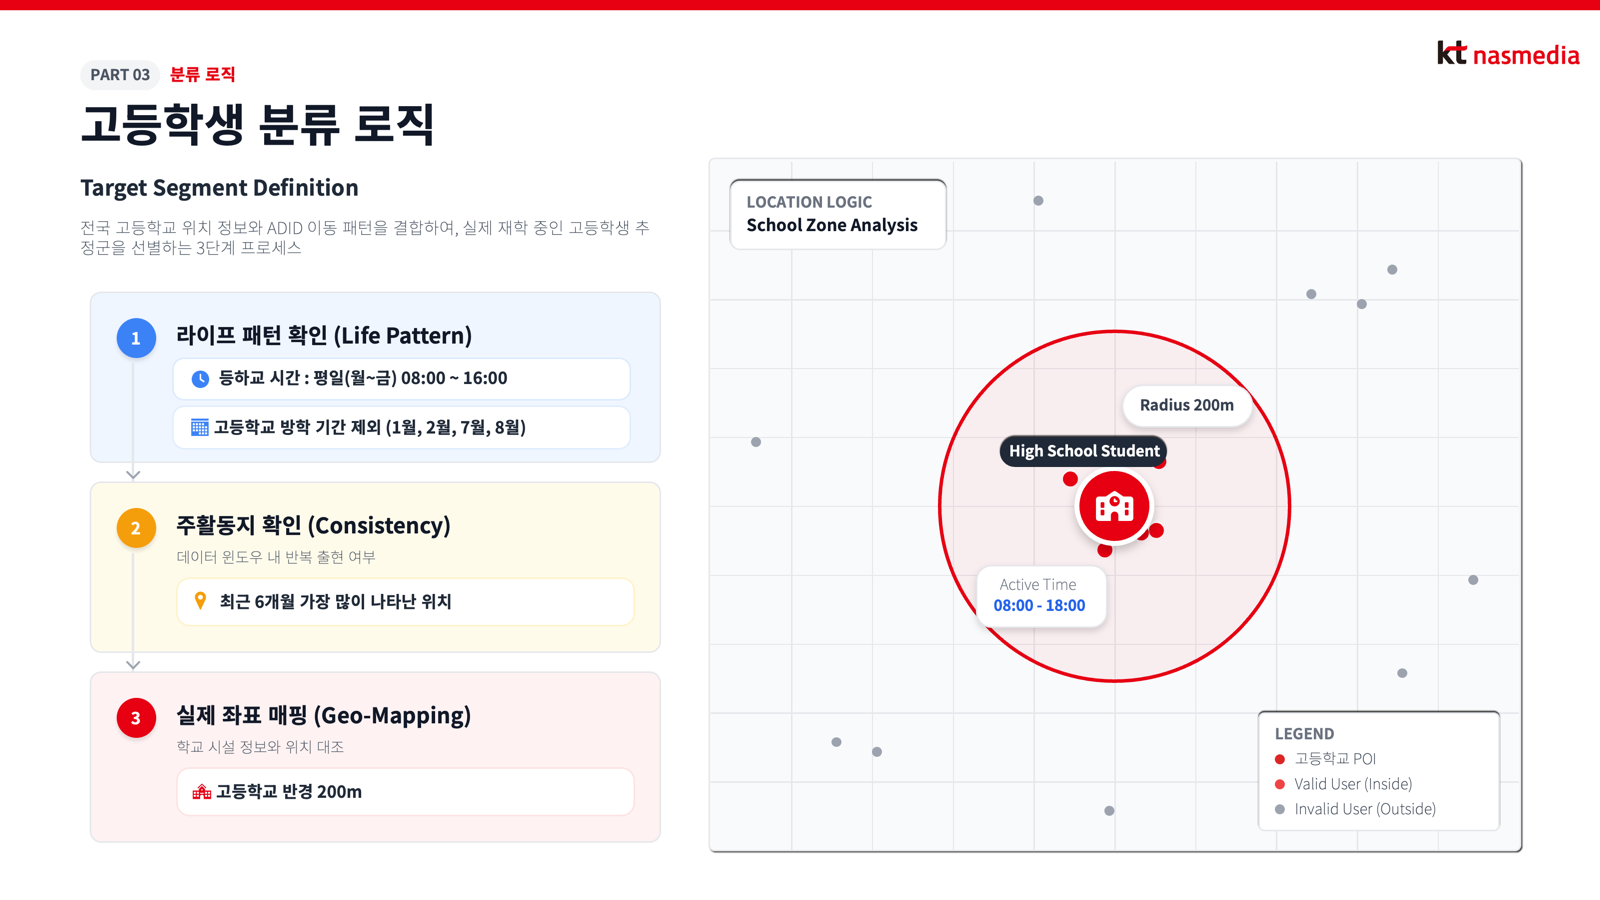
- 고등학생
- 평일 09:00 ~ 16:00 주활동지가 고등학교인 ADID
- 고등학교 방학기간(1, 2, 7, 8월)은 제외
연령 10대 ADID 교집합
-- 고등학교 좌표 매핑 전 고등학생 후보군
CREATE TABLE IF NOT EXISTS jaeyoung.high_std_candidate (
  adid STRING,
  lat DOUBLE,
  lon DOUBLE
)
PARTITIONED BY (base_ym STRING)
STORED AS PARQUET;

INSERT INTO TABLE jaeyoung.high_std_candidate
PARTITION (base_ym = '${a2_end_trgt_base_ym}')
SELECT
    adid,
    lat,
    lon,
FROM (
    SELECT
        adid,
        lat,
        lon,
        ROW_NUMBER() OVER (PARTITION BY adid ORDER BY visit_days DESC, total_stay DESC) AS rnk
    FROM (
        SELECT
            adid,
            lat,
            lon,
            COUNT(DISTINCT base_ymd) as visit_cnt  -- 방문 일수
            SUM(stay_cnt) as total_stay -- 체류 강도로 작용
        FROM
            jaeyoung.job_segment_base
        WHERE
            base_ym = '${a1_strt_trgt_base_ym}' AND base_ym <= '${a2_end_trgt_base_ym}' -- 6개월 단위 계산 가능시 6개월 계산
            AND base_hh >= '09' AND base_hh <= '16'  -- 고등학생 타겟 시간
            AND SUBSTR(base_ym, 5, 2) NOT IN ('01', '02', '07', '08')  -- 방학 기간 제외
        GROUP BY
            adid,
            lat,
            lon
        HAVING COUNT(DISTINCT base_ymd) >= 2
    ) agg
) ranked
WHERE rnk = 1;
(202509 ~ 202511 기준) unique adid 수 - 약 1400만 건
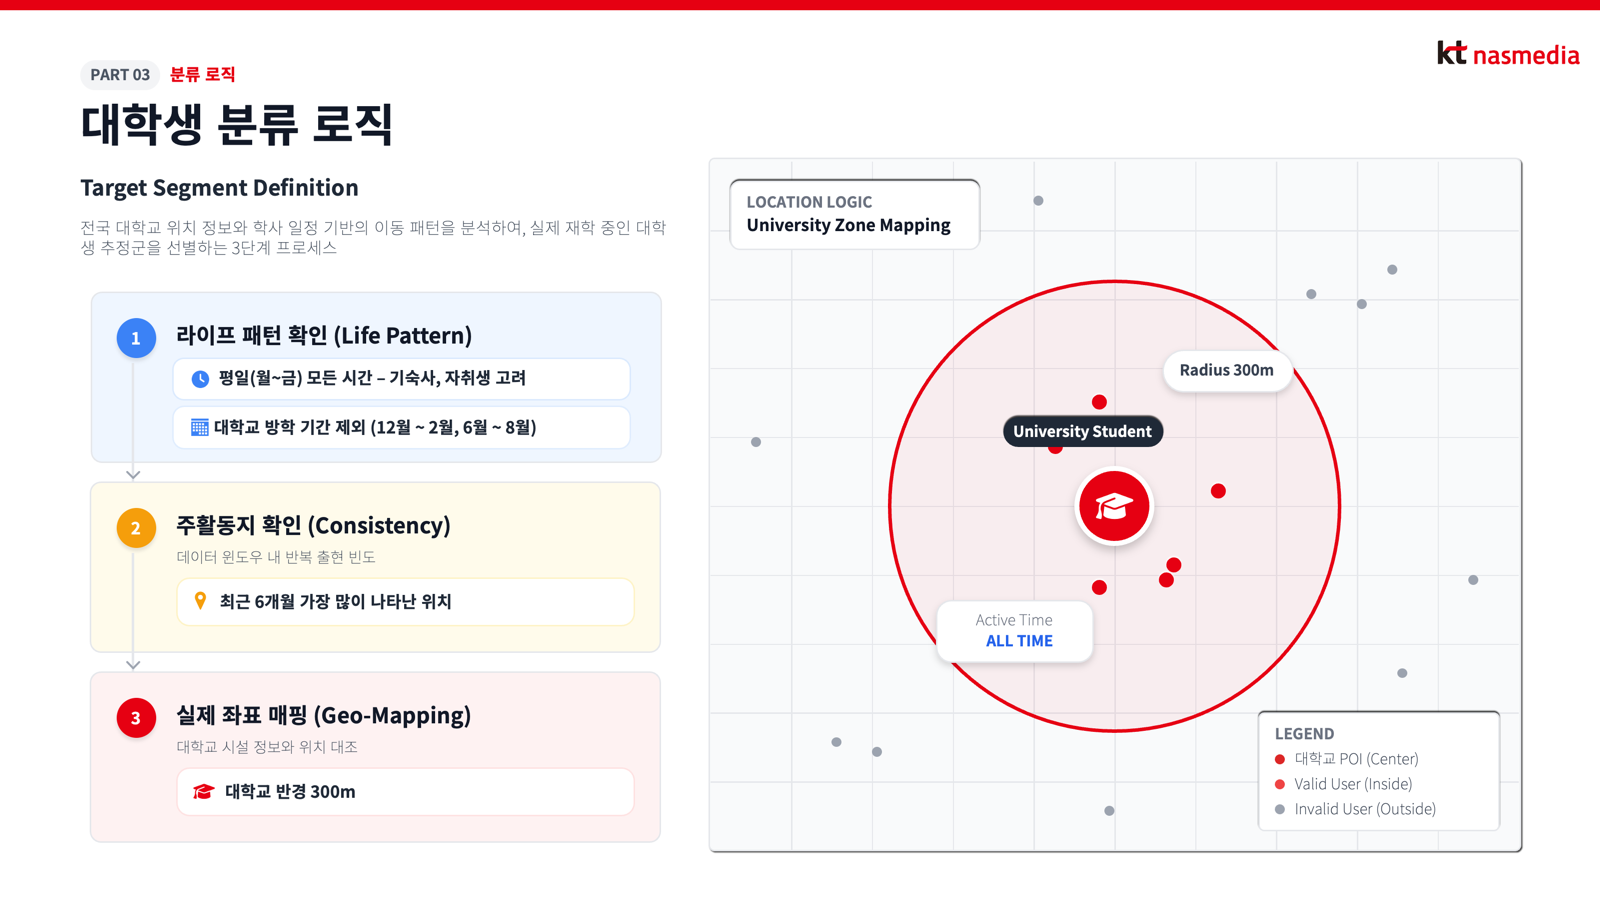
- 대학생
- 평일 주활동지가 대학교 근처인 ADID
- 기숙사 거주를 하는 경우가 있으므로 주활동지 시간은 주간 + 야간, 대학교 방학 기간(12월, 1, 2, 6, 7, 8월)은 제외
연령 20대 ADID 교집합
-- 대학교 좌표 매핑 전 대학생 후보군
CREATE TABLE IF NOT EXISTS jaeyoung.univ_std_candidate (
  adid STRING,
  lat DOUBLE,
  lon DOUBLE
)
PARTITIONED BY (base_ym STRING)
STORED AS PARQUET;

INSERT INTO TABLE jaeyoung.univ_std_candidate
PARTITION (base_ym = '${a2_end_trgt_base_ym}')
SELECT
    adid,
    lat,
    lon,
FROM (
    SELECT
        adid,
        lat,
        lon,
         ROW_NUMBER() OVER (PARTITION BY adid ORDER BY visit_days DESC, total_stay DESC) AS rnk
    FROM (
        SELECT
            adid,
            lat,
            lon,
            COUNT(DISTINCT base_ymd) as visit_days -- 방문 일수
            SUM(stay_cnt) as total_stay -- 총 체류 강도
        FROM
            jaeyoung.job_segment_base
        WHERE
            base_ym = '${a1_strt_trgt_base_ym}' AND base_ym <= '${a2_end_trgt_base_ym}' -- 6개월 단위 계산 가능시 6개월 계산
            AND SUBSTR(base_ym, 5, 2) NOT IN ('01', '02','06','07', '08', '12')
        GROUP BY
            adid,
            lat,
            lon
        HAVING COUNT(DISTINCT base_ymd) >= 2
    ) agg
) ranked
WHERE rnk = 1;
(202509 ~ 202511 기준) unique adid 수 - 약 2000만 건
근로자
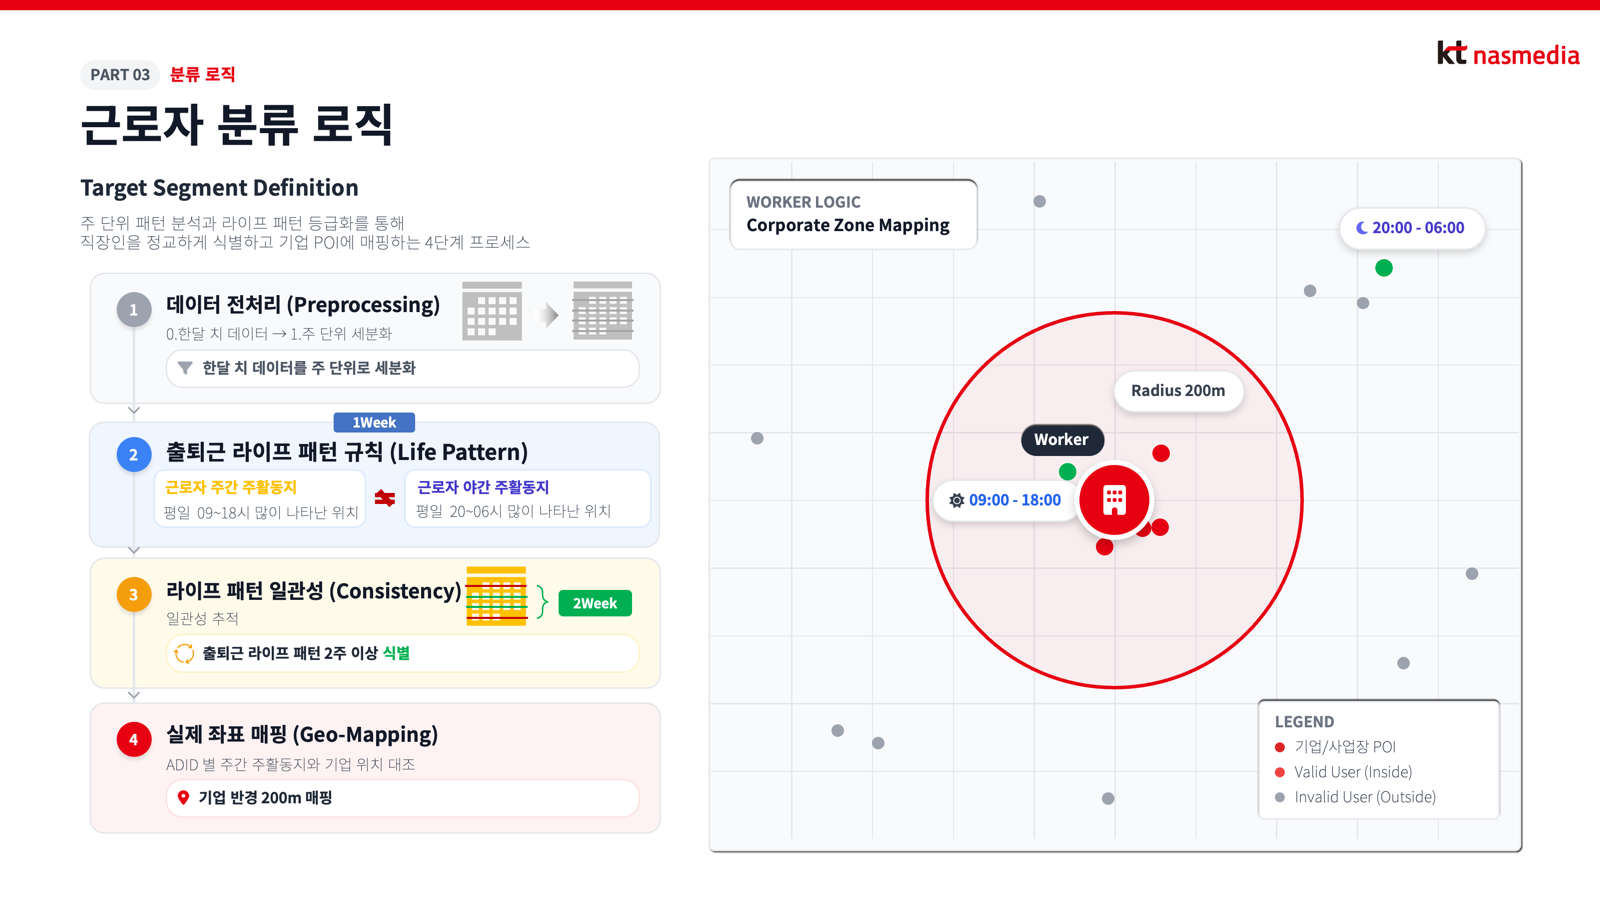
: 주거지와 근무지가 분리된 이동 패턴을 통해 경제 활동 인구를 식별.
- 신분 식별
- 평일 낮(09시~18시)의 주활동지와, 밤(20시~06시)의 주활동지 위치가 서로 다른 패턴이 한 달에 2주(Week) 이상 반복된다면 근로자.
- → 월간 통합 기준이 아닌 주 단위 검증을 통해, 일시적 이동(출장/여행)을 배제하고 반복적인 출퇴근 *라이프 사이클’을 확인
- 직업 식별
- 평일 주간(09:00 ~ 18:00) 주활동지가 위치가 '회사/오피스' 위치와 일치하는 ADID
INSERT INTO TABLE jaeyoung.worker_candidate
PARTITION (base_ym = '${a2_end_trgt_base_ym}')
SELECT
    adid,
    'DAY' AS time_type,
    lat,
    lon
FROM (
    -- [Step 4] 유저별로 가장 많이 나타난 직장 좌표 딱 하나만 선정
    SELECT
        adid,
        day_lat AS lat,
        day_lon AS lon,
        ROW_NUMBER() OVER (PARTITION BY adid ORDER BY repeated_weeks DESC) as final_rnk
    FROM (
        -- [Step 3] 기존 로직: 동일 주차 내 낮/밤 위치가 다른 2주 이상의 케이스
        SELECT
            d.adid,
            d.day_lat,
            d.day_lon,
            COUNT(DISTINCT d.week_num) as repeated_weeks
        FROM (
            -- [Step 1] 주차별 낮 최다 빈도
            SELECT adid, week_num, lat as day_lat, lon as day_lon
            FROM (
                SELECT adid, week_num, lat, lon,
                       ROW_NUMBER() OVER (PARTITION BY adid, week_num ORDER BY visit_days DESC, total_stay DESC) as rnk
                FROM (
                    SELECT adid, weekofyear(from_unixtime(unix_timestamp(base_ymd, 'yyyyMMdd'))) as week_num, lat, lon,
                           COUNT(DISTINCT base_ymd) as visit_days, SUM(stay_cnt) as total_stay
                    FROM jaeyoung.job_segment_base
                    WHERE base_ym = '${a2_end_trgt_base_ym}' AND base_hh >= '09' AND base_hh <= '18'
                    GROUP BY adid, weekofyear(from_unixtime(unix_timestamp(base_ymd, 'yyyyMMdd'))), lat, lon
                ) t1
            ) t2 WHERE rnk = 1
        ) d
        JOIN (
            -- [Step 2] 주차별 밤 최다 빈도
            SELECT adid, week_num, lat as night_lat, lon as night_lon
            FROM (
                SELECT adid, week_num, lat, lon,
                       ROW_NUMBER() OVER (PARTITION BY adid, week_num ORDER BY visit_days DESC, total_stay DESC) as rnk
                FROM (
                    SELECT adid, weekofyear(from_unixtime(unix_timestamp(base_ymd, 'yyyyMMdd'))) as week_num, lat, lon,
                           COUNT(DISTINCT base_ymd) as visit_days, SUM(stay_cnt) as total_stay
                    FROM jaeyoung.job_segment_base
                    WHERE base_ym = '${a2_end_trgt_base_ym}' AND (base_hh >= '20' OR base_hh <= '06')
                    GROUP BY adid, weekofyear(from_unixtime(unix_timestamp(base_ymd, 'yyyyMMdd'))), lat, lon
                ) t3
            ) t4 WHERE rnk = 1
        ) n ON d.adid = n.adid AND d.week_num = n.week_num
        WHERE (d.day_lat <> n.night_lat OR d.day_lon <> n.night_lon)
        GROUP BY d.adid, d.day_lat, d.day_lon
        HAVING COUNT(DISTINCT d.week_num) >= 2
    ) tmp
) final_selection
WHERE final_rnk = 1;
(202511 기준) unique adid 수 - 약 156만 건
각 직업별로 후보군이 선별 되면 ADID들의 주활동지와 실제 시설의 위치를 매핑 하여 ADID의 직업을 유추
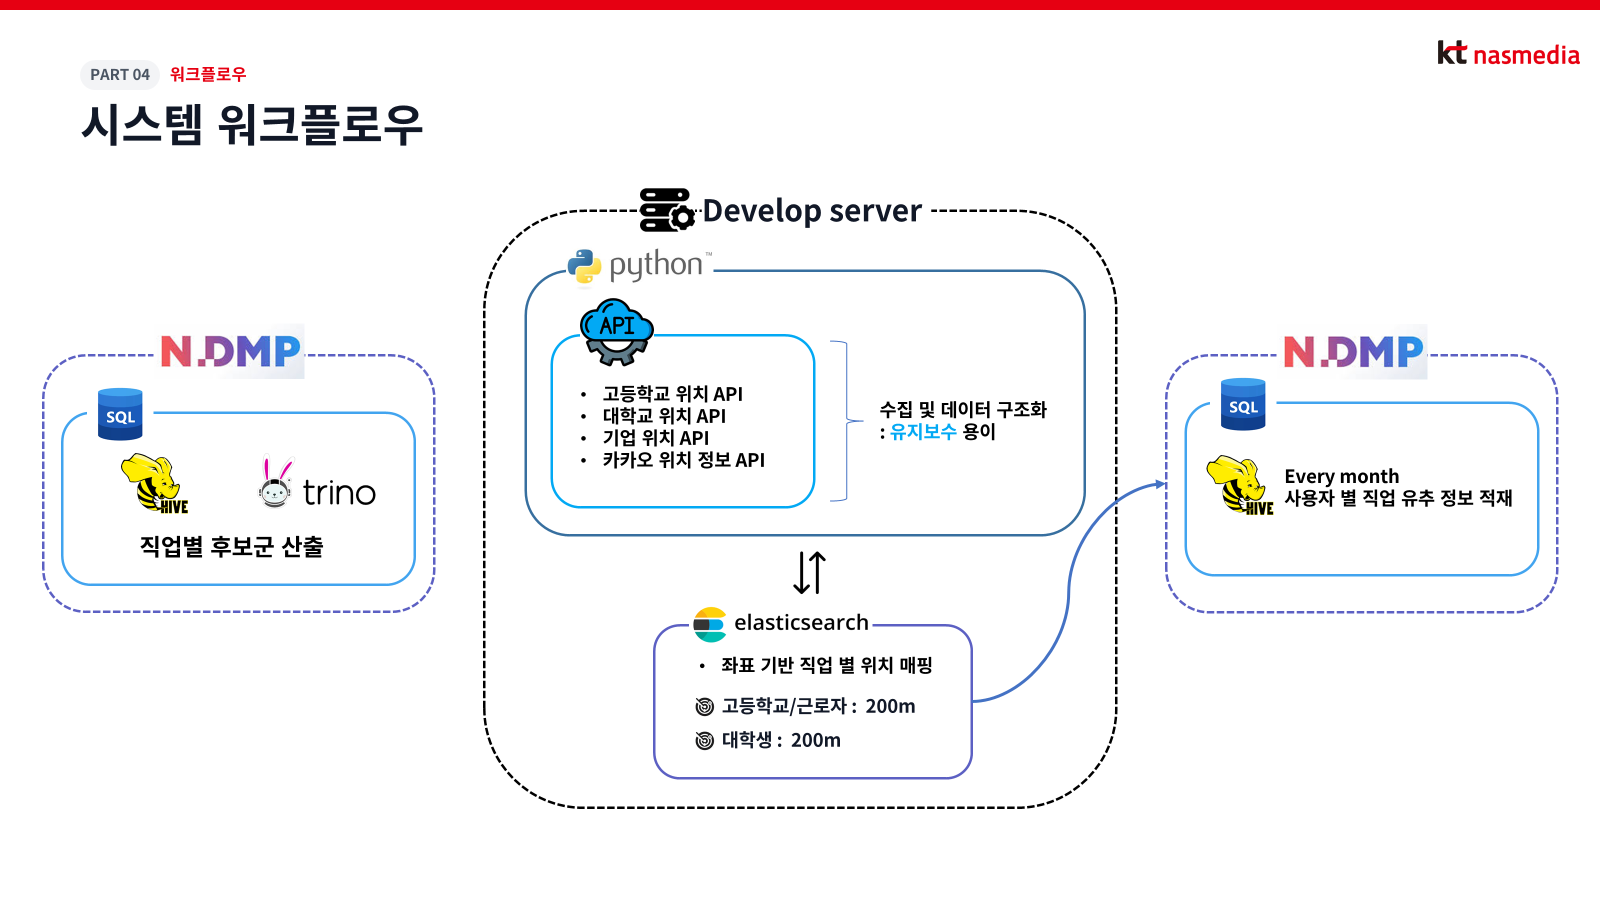
개발 서버 내 좌표 기반 정밀 매핑 코드
hub.com/jojaeyoung777-spec/2025-kt-nasmedia-DMP-occupation-segment
3. 직업 세그먼트 보고서, 발표 자료
'프로젝트 > kt나스미디어 현장실습 인턴' 카테고리의 다른 글
| 광고 데이터 CVR 예측 모델링_5221 - (EDA) (0) | 2026.04.06 |
|---|---|
| 광고 데이터 CVR 예측 모델링_5221 - (1차 가설 설정) (0) | 2026.04.06 |
| 광고 데이터 CVR 예측 모델링 - (퀄리티 체크) (0) | 2026.04.06 |
| 쿠팡플레이 주간 리포트 자동화 (0) | 2026.02.04 |
| 광고 데이터 CVR 예측 모델링 - (보완 및 2차 가설 설정) (0) | 2025.12.30 |